LLM ALIGNMENT
Alignment Data Map: 측정값에서 선호 학습 쌍까지
Ilho Ahn
Alignment Data Map의 상대 좌표가 reference answer와 텍스트 처리에 따라 달라지고, 지시문 선택 뒤 실제 선호 학습 쌍의 구성이 다시 달라지는 과정을 추적한다.
Lee et al.의 Alignment Data Map(ADM) [1]은 한 지시문의 후보 응답에서 계산한 alignment score의 평균과 분산으로 선호 데이터를 구분해 학습 데이터를 선택하는 방법이다. 그러나 ADM 영역만으로는 이 좌표가 reference answer와 텍스트 처리 방식에 따라 얼마나 달라지는지, 선택된 지시문이 어떤 학습 쌍으로 구체화되는지 알 수 없다. 이 글에서는 4,500개 지시문을 대상으로, 측정 조건에 따른 좌표와 영역의 변화부터 선택된 지시문이 실제 선호 학습 쌍으로 변환되는 과정까지 분석했다.
요약
- 4,500개 지시문과 지시문당 후보 응답 4개를 대상으로 ADM 측정값이 실제 선호 학습 쌍으로 바뀌는 과정을 추적했다.
- Reference answer 생성 정책과 장문 처리 방식이 달라지면 같은 지시문의 ADM 영역도 달라졌다.
- 지시문 구성을 맞춰도 실제 응답 쌍의 점수 차이, 선호 방향, 반복 노출은 같아지지 않았다.
- 단일 seed 학습 비교에서는 영역별 결과 차이가 관찰됐지만, ADM 영역 자체의 효과로 분리되지는 않았다.
문제 설정
ADM은 후보 응답별 alignment score의 평균과 변동을 이용해 지시문을 HighAvg·LowAvg·HighVar 영역으로 나눈다. 원 ADM 연구는 LLM-as-a-judge, reward model, reference-based scoring으로 alignment score를 측정했다. 이 가운데 높은 평균과 낮은 변동을 보인 HighAvg 표본 33%만으로 학습해도, 전체 데이터를 사용한 학습과 비교해 MT-Bench, Evol-Instruct, AlpacaEval에서 비슷하거나 더 높은 alignment 성능을 얻었다고 보고했다 [1].
그러나 집계 학습 성능의 안정성이 동일한 지시문의 좌표와 영역까지 안정적이라는 뜻은 아니다. 이 글은 두 질문을 구분한다. 첫째, reference answer와 텍스트 처리 방식이 달라질 때 동일한 지시문의 ADM 좌표와 영역이 얼마나 유지되는가. 둘째, 각 영역에서 선택된 지시문이 실제 선호 학습 쌍으로 변환될 때 어떤 학습 신호가 형성되는가.
두 질문은 연결되어 있지만 분석 단위가 다르다. ADM은 지시문을 선택하지만 실제 선호 학습은 chosen–rejected 응답 쌍을 사용한다. 하나의 지시문에서 여러 응답 쌍이 만들어질 수 있으며, 각 쌍의 점수 차이와 선호 방향도 다를 수 있다.
따라서 이 글은 ADM의 reference-based measurement가 실제 SimPO 선호 쌍으로 이어지는 과정을 하나의 실험 사례로 수치화한다. 분석 대상은 지시문 단위 선택 뒤에 형성되는 응답 쌍 단위 학습 신호이며, 특정 selection rule의 일반적 우위나 새로운 data-construction pipeline을 제안하지 않는다.
관련 연구
평균과 변동으로 데이터의 특성을 구분하는 관점은 Swayamdipta et al.의 Dataset Cartography [2]에서 이어지며, ADM은 이를 선호 데이터 선택에 적용한다. Song의 data-centric alignment pipeline [3]은 alignment data construction을 response synthesis, preference evaluation, preference instantiation으로 나눈다. 이 구분은 ADM의 측정과 실제 선호 쌍 구성이 서로 다른 단계임을 설명하는 틀을 제공한다.
선호 데이터에서 응답 쌍의 점수 차이와 구성은 Yang et al. [4], Deng et al. [5], Xiao et al. [6]이 다뤘고, Pan et al.은 chosen 응답의 품질을 분석했다 [7]. 이 글은 새로운 selection rule을 비교하기보다, ADM에서 선택된 지시문이 실제 학습 쌍으로 구체화될 때 형성되는 응답 쌍 단위 신호에 초점을 둔다.
평가 설계
측정 조건과 비교 단위
이 글의 결과는 하나의 고정 지도에서 모두 나온 것이 아니다. Table 1은 reference 비교, 장문 처리, 출처별 재구성, 학습 평가를 구분한다.
| 비교 | 대상 단위 | 바뀐 조건 / 해석 역할 |
|---|---|---|
| Reference answer | 100개 지시문; 별도 60개 표본 | 후보 응답을 유지하고 reference 생성 정책을 비교 |
| 장문 처리 | 4,500개 지시문 × 후보 4개 | 동일 reference에서 prefix·head–tail·overlapping-window 점수 비교 |
| 출처·과제별 지도 재구성 | 같은 4,500개 지시문 | 전체 코호트 경계와 출처×과제 층별 영역을 구분 |
| 선호 학습 | 3,240개 지시문 → 17,301쌍 | 영역별 파이프라인을 비중복 개발 600쌍에서 평가 |
Reference 기반 측정과 영역 구성
측정 코호트는 UltraFeedback [8]에서 원천 데이터셋, 과제 유형, 지시문 길이를 고려해 뽑은 4,500개 지시문과 지시문당 후보 응답 4개로 구성했다. Reference answer는 Qwen3.5-122B-A10B의 non-thinking 설정에서 temperature 0, 최대 4,096토큰으로 생성했다.
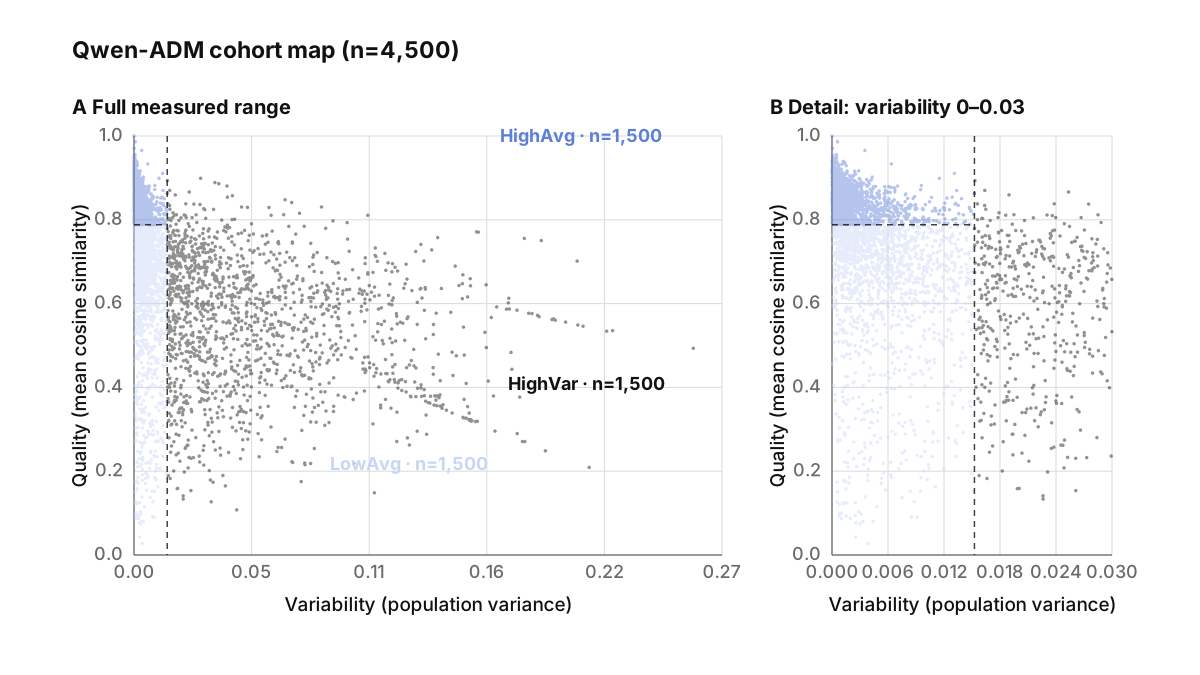
각 후보 응답은 Sentence-BERT 계열의 all-mpnet-base-v2 [9] [10]로 reference answer와의 cosine similarity를 계산했다. 앞부분 기준선은 최대 384토큰을 사용한다. 지시문별 네 유사도의 평균을 quality, 모분산을 variability로 두고, 전체 코호트의 상대 순위에 따라 LowAvg·HighAvg·HighVar를 각 1,500개로 나눴다. 따라서 영역은 절대 등급이 아니라 해당 reference answer·채점 방식·코호트 안의 상대적 위치다.
이 글에서 quality는 후보 응답과 reference answer 사이의 평균 문장 임베딩 유사도다. 응답 품질 전반이나 인간 선호와의 일치를 뜻하지 않는다.
실제 학습 쌍 분석에는 중첩 창 평균으로 다시 계산하고 출처×과제 유형별로 나눈 지도를 사용했다. 이 조건은 전체 코호트에서 직접 나눈 초기 지도와 동일하지 않다.
선호 쌍과 학습 비교
ADM은 지시문을 선택하지만, Meng et al.의 SimPO [11]는 chosen–rejected 응답 쌍을 학습한다. 이 분석에서는 출처 평점이 다른 모든 후보 응답 쌍을 만들고, 출처×과제 유형별 지시문 할당량을 세 영역에서 맞췄다. 실제 학습 split은 영역당 1,080개, 총 3,240개 지시문으로 구성되었고, 이를 확장한 최종 학습 데이터는 17,301쌍이다.
Qwen2.5-3B-Instruct는 LoRA·SimPO로 최대 5 epoch 학습했다. 학습률은 5e-6, global batch는 63이다. 영역별 전용 개발 세트에서 선호 방향 일치 쌍 수, loss, 이른 시점 순으로 모델을 선택한 뒤, 학습 데이터와 prompt·pair가 겹치지 않는 동일한 600쌍 개발 세트에서 비교했다. 분석에서는 ADM이 선택하는 지시문과 SimPO가 학습하는 응답 쌍을 구분해 추적했다.
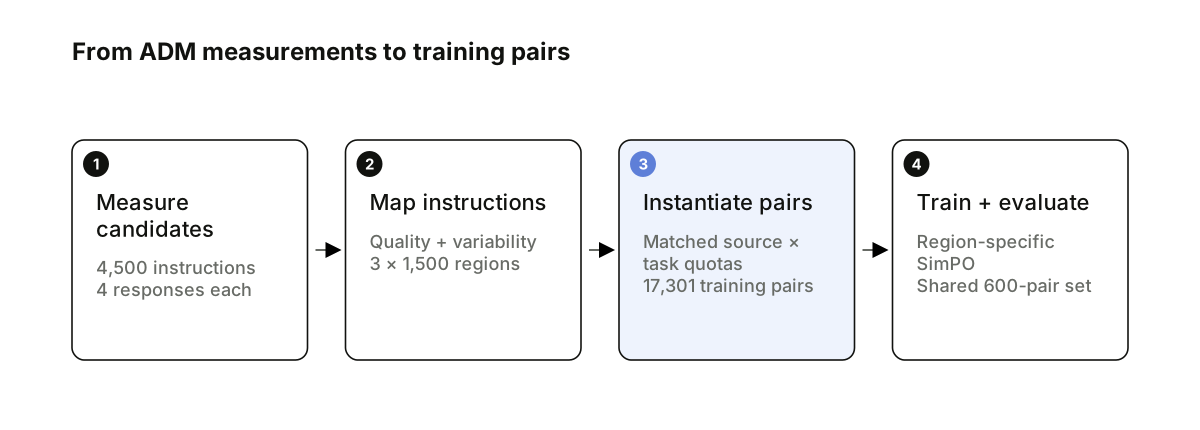
Figure 1은 reference-conditioned candidate measurement에서 영역별 SimPO 평가까지의 전체 경로를 요약한다.
결과
Reference answer와 장문 처리 민감도
같은 100개 지시문과 동일한 후보 응답에 GPT-4o와 Qwen3.5의 reference answer 생성 정책을 적용했을 때 후보 순서 일치율은 .760이었고, 95% bootstrap CI는 .710–.808이었다. 분산 순위 상관은 .854, 영역 macro-F1은 .7395였으며, 64/100개 지시문에서 적어도 한 번의 후보 순서 반전이 있었다.
별도의 공통 60개 표본에서 GPT-4o, Qwen3.5, gpt-oss-120B 3회 반복을 쌍별로 비교했을 때 후보 순서 일치율 .7722–.8472, 영역 macro-F1 .6500–.8000이 관찰됐다.
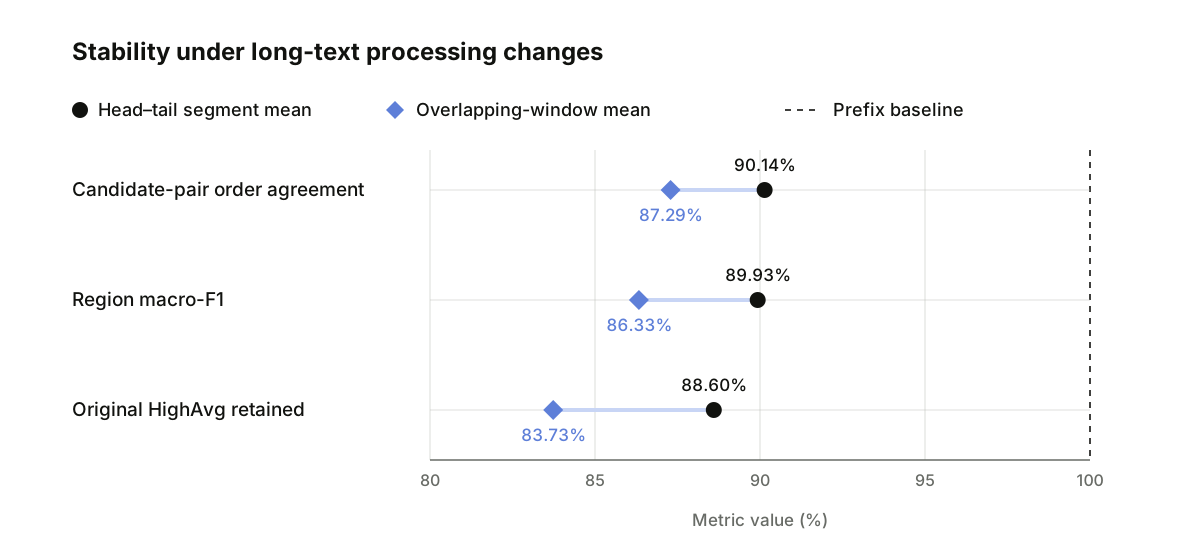
후보 응답과 reference answer를 고정하고 장문 처리 방식만 바꿔도 영역 이동이 남았다. Figure 2에서 세 지표는 높을수록 앞부분 기준선에 가깝다. Overlapping-window mean은 모든 지표에서 Head–tail segment mean보다 기준선에서 더 멀었다.
코호트 구성과 영역 연관
Figure 3은 전체 4,500개 지시문의 ADM 좌표와 상대 순위 경계를 보여 준다. 세 영역은 각각 1,500개지만, 그 안의 데이터 출처, 지시문 길이, 과제 유형 구성은 같지 않았다.
데이터 출처와 ADM 영역 배정 사이의 연관성은 Cramér’s V .388이었다. 영역별 구성을 보면 HighAvg 표본의 69.7%는 Evol-Instruct에서, HighVar 표본의 58.4%는 FLAN/NIV2에서 왔다. 지시문 길이 사분위와 영역 배정 사이의 Cramér’s V는 .192였으며, 평균 지시문 길이는 HighAvg 487자, HighVar 888자였다. 과제 유형과 영역 배정 사이의 Cramér’s V는 .160이었고, Code 지시문의 44.83%와 Multi-constraint 지시문의 23.54%가 HighAvg에 배정됐다.
중첩 창 평균 지도에서 과제 유형만 고려한 HighAvg 학습–개발 세트의 출처 분포 TV는 .289였다. 출처×과제 유형별로 재구성한 뒤에는 .030으로 감소했다. 이는 출처 구성을 직접 맞춘 결과지만, 이 과정에서 1,387/4,500개의 영역과 선택된 지시문·응답 쌍이 함께 바뀌었다. 따라서 이후 학습 차이에는 여러 데이터 구성 변화가 함께 포함된다.
지시문 선택과 실제 선호 쌍
별도의 HighAvg 데이터 구성에서 종합 품질 평점 방향과 alignment score 방향은 동점이 아닌 3,229쌍 중 862쌍, 즉 26.7%에서 반대였다. ADM의 지시문 선택과 응답 쌍의 선호 레이블 결정은 같은 단계가 아니다. 이 26.7%와 Table 2의 HighAvg 32.95%는 서로 다른 데이터 구성에서 나온 값이므로 같은 모집단의 반복 측정으로 비교하지 않는다.
출처×과제 유형별 지시문 할당량을 맞춘 세 영역에서도 실제 학습 쌍의 구성이 달랐다. Table 2에서 출처 평점과 alignment score의 차이는 절댓값이다. 두 점수의 방향 반대 비율은 낮을수록 두 기준이 더 자주 일치한다.
| Region | Training pairs | Source-rating gap median |
Alignment-score gap median |
Alignment-score gap <.05 |
Opposite direction | Mean pairs per instruction |
|---|---|---|---|---|---|---|
| LowAvg | 5,774 | 1.000 | .0727 | 36.91% | 37.51% | 5.346 |
| HighAvg | 5,682 | .750 | .0490 | 50.70% | 32.95% | 5.261 |
| HighVar | 5,845 | 1.250 | .2047 | 17.74% | 26.48% | 5.412 |
지시문 기준 출처×과제 유형 TV는 0이었지만, 응답 쌍 확장 뒤 출처×과제 유형 TV는 .0101–.0127, 길이 구간 TV는 .0418–.0728로 남았다. 지시문 구성을 맞추는 것만으로 응답 쌍의 방향, 점수 차이, 반복 노출까지 같아지지는 않았다.
단일 seed 파이프라인 비교
Reward accuracy는 모델이 chosen 응답에 rejected 응답보다 높은 reward를 부여한 쌍의 비율이며 높을수록 좋다. Reward margin은 두 reward의 평균 차이이며 높을수록 좋다. SimPO loss는 목표 margin 미달과 음수 margin 꼬리에 민감하며 낮을수록 좋다.
Table 3은 영역별 모델 선택을 포함한 세 파이프라인과 기초 모델을 동일한 600쌍 공통 개발 세트에서 비교한다.
| Pipeline | Preferred-direction matches | Reward accuracy | Reward accuracy Δ vs. base model |
SimPO loss | Reward margin |
|---|---|---|---|---|---|
| Qwen base | 378/600 | 63.00% | — | 1.253075 | 1.395679 |
| LowAvg | 421/600 | 70.17% | +7.17pp | 1.031459 | 1.506562 |
| HighVar | 431/600 | 71.83% | +8.83pp | 1.031298 | 1.573699 |
| HighAvg | 442/600 | 73.67% | +10.67pp | 1.019236 | 2.149893 |
이 단일 seed 비교에서 HighAvg는 HighVar보다 선호 방향 일치가 11쌍 많았고, reward accuracy·reward margin·SimPO loss에서 가장 좋은 관측값을 기록했다.
파이프라인 해석
ADM 좌표는 reference answer와 텍스트 처리 방식에 의존하는 상대적 측정값이며, 지도에서 선택되는 단위와 실제 학습 단위도 각각 지시문과 응답 쌍으로 다르다. 지시문 할당량을 같게 맞춰도 pair margin, 방향 불일치, 지시문당 반복 노출은 달라졌다.
데이터 선택을 재현하고 학습 결과의 범위를 해석하려면 ADM 영역 이름뿐 아니라 reference answer 생성 조건, 후보 응답 집합, 텍스트 처리 방식, 코호트와 영역 경계, 응답 쌍 구성 규칙, 실제 응답 쌍 단위 분포를 함께 기록해야 한다.
한계와 후속 비교
- Reference answer 비교에서는 모델과 생성 설정을 함께 바꿨고, 60개 표본의 범위는 신뢰구간이 아니라 쌍별 비교와 반복 실행을 요약한 값이다. 측정 타당성을 확인하려면 같은 4,500개 지시문과 후보 응답 집합에 여러 reference answer를 적용하고, 장문 채점 방식을 사람 평가나 과제 정답에 근거한 주석과 비교해야 한다.
- 공통 600쌍은 반복 사용된 개발 세트이며 쌍 단위 신뢰구간을 계산하지 않았다. 파이프라인 비교에는 무작위 선택과 전체 데이터 조건이 없고, 모든 학습 결과는 하나의 seed에서 나왔다. 영역별 모델 선택과 응답 쌍 구성도 함께 달라져 ADM 영역 자체의 효과를 분리할 수 없다. 후속 비교에서는 데이터 구성·모델·학습 설정을 고정하고 응답 쌍 방향만 바꾼 조건을 여러 seed로 확인해야 한다.
- 외부 데이터와 downstream benchmark에 대한 일반화는 평가 범위에 포함하지 않았다.
후속 글은 HighAvg–Random을 여러 시드와 고정된 update 예산에서 비교한다. 그 결과가 이 글의 reference 측정이나 선호 방향 혼입을 소급해서 통제하는 것은 아니다.
Appendix: 주요 지표
- Reference answer와의 평균 유사도: 네 후보 응답과 reference answer 사이의 MPNet cosine similarity 평균.
- Variability: 네 유사도 점수의 모분산(
ddof=0). - 후보 응답 순서 일치율: 네 후보가 만드는 여섯 쌍에서 두 reference answer에 따른 순서가 같은 비율.
- 영역 macro-F1: 두 ADM 영역 배정의 클래스별 F1을 동일 가중 평균한 값.
- Cramér’s V: 영역과 출처·과제 유형·길이 범주의 연관 크기.
- 출처 분포 거리(TV): 두 세트의 출처 비율 차이인 $\frac{1}{2}\sum_i\lvert p_{1,i}-p_{2,i}\rvert$.
- Reward accuracy·reward margin·SimPO loss: 각각 선호 방향 일치 비율, 평균 reward 차이, 목표 margin 미달과 음수 margin 꼬리를 반영한 loss.
References
- Lee, S., Kim, E., Lee, H., and Chang, B. Alignment Data Map for Efficient Preference Data Selection and Diagnosis. Findings of ACL 2026, 38225–38241, 2026. ACL Anthology; arXiv
- Swayamdipta, S. et al. Dataset Cartography: Mapping and Diagnosing Datasets with Training Dynamics. EMNLP 2020, 9275–9293, 2020. ACL Anthology
- Song, H. Alignment Tuning for Large Language Models: A Data-Centric Lens on Alignment Data Pipelines. Findings of ACL 2026, 2541–2561, 2026. ACL Anthology
- Yang, S. et al. Not All Preference Pairs Are Created Equal: A Recipe for Annotation-Efficient Iterative Preference Learning. Findings of EMNLP 2024, 6549–6561, 2024. ACL Anthology
- Deng, X. et al. Less is More: Improving LLM Alignment via Preference Data Selection. arXiv:2502.14560, 2025. arXiv
- Xiao, Y. et al. Finding the Sweet Spot: Preference Data Construction for Scaling Preference Optimization. ACL 2025, 12538–12552, 2025. ACL Anthology
- Pan, Y. et al. What Matters in Data for DPO? NeurIPS 2025, 44689–44716, 2025. NeurIPS
- Cui, G. et al. UltraFeedback: Boosting Language Models with Scaled AI Feedback. ICML 2024, 9722–9744, 2024. PMLR; Dataset
- Reimers, N. and Gurevych, I. Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks. EMNLP-IJCNLP 2019, 3982–3992, 2019. ACL Anthology
- Song, K., Tan, X., Qin, T., Lu, J., and Liu, T.-Y. MPNet: Masked and Permuted Pre-training for Language Understanding. NeurIPS 2020, 16857–16867, 2020. NeurIPS
- Meng, Y., Xia, M., and Chen, D. SimPO: Simple Preference Optimization with a Reference-Free Reward. NeurIPS 2024, 124198–124235, 2024. NeurIPS
모델 및 데이터셋 리소스: Qwen3.5-122B-A10B, Qwen2.5-3B-Instruct, all-mpnet-base-v2, UltraFeedback.
Citation
Text citation:
Ilho Ahn, "Alignment Data Map: 측정값에서 선호 학습 쌍까지", Ilho’s Notes, August 23, 2026.
BibTeX:
@article{ahn2026admmeasurementpreferencepairs,
  author = {Ilho Ahn},
  title = {Alignment Data Map: 측정값에서 선호 학습 쌍까지},
  journal = {Ilho’s Notes},
  year = {2026},
  month = aug,
  url = {https://muted-color.github.io/research/2026/08/23/adm-measurement-to-preference-pairs/ko/}
}